三校团队首次量化扩散模型计数幻觉,RealHand子集含5050张手像
要点
阿德莱德大学、美团与上海交通大学的研究团队首次量化扩散模型计数幻觉,发现RealHand子集在DPM-Solver-1下采样步数从25步增至100步时,计数幻觉率反升至14.55%,且JDM方法虽降低幻觉但推高FID指标。
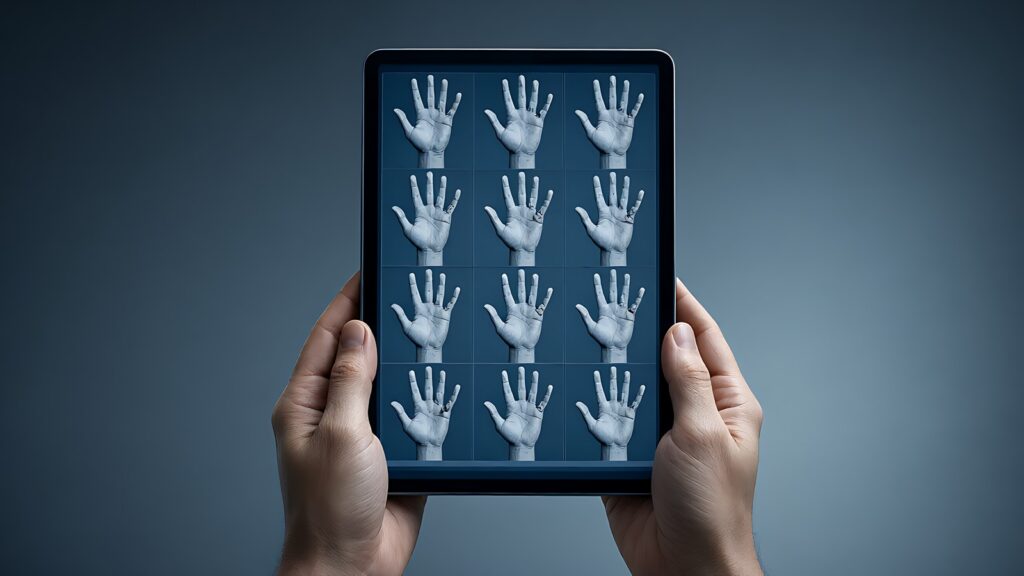
研究团队首先补上了一个基础工具:CountHalluSet 数据集套件,它的三个子集按可数物体的形态复杂度逐级递增。ToyShape 包含 30000 张图,只放三角形、正方形、五边形三种白色几何图形,每种面积均为 120 像素,同一张图内互不重叠;SimObject 包含 30000 张用虚幻引擎 5 渲染的日常物体图,物体分为马克杯、苹果、时钟三类,每类有 10 种类内变化,统一摆放在木桌面上、固定光照;RealHand 由 5050 张人手图像构成,素材取自 11k Hands 数据集、Kaggle 与 Roboflow,清除了模糊和带伪影的样本,同时覆盖手背与掌心视角、不同光照和背景。
三个子集各有自己的计数规则。ToyShape 和 SimObject 要求每张图中每个类别最多出现一个实例,且至少存在一个对象;RealHand 则要求每张图严格包含五根手指。违反这些规则的输出即被判定为计数幻觉,比如一张图里出现了两个苹果,或者只生成了背景而没有任何对象——后者在 SimObject 中从未出现过。
要判定“数错了几个”,还需要自动计数模型。ToyShape 与 SimObject 使用 ResNet-50 微调,用超过 40 万条数据训练,每个类别在单个样本中出现 0 到 3 次,该模型在生成数据上的计数准确率超过 99.9%。RealHand 的流程更复杂:团队先用 MaxViT 微调出一个“可计数性指示器”,用来区分计数幻觉样本和其他类型的失败样本(例如严重变形的手指),这个二分类器在 2500 张标注的生成图像上训练,经三名标注者对 500 张随机样本的人工评估,准确率超过 96%;随后用 YOLO-12 微调检测指尖来统计数量,该检测模型在 2000 张指尖标注的生成图像上训练,准确率超过 99%。
量化结果首先推翻了“步数越多越好”的直觉。在常用的 ODE 求解器设置下(25、50、100 步),增加采样步数能有效降低合成数据集上的计数幻觉率,但在真实手部数据上却起了反作用。用标准高斯噪声时,DPM-Solver-1 在 RealHand 上的计数幻觉率随步数上升:25 步为 12.95%,50 步 13.85%,100 步 14.55%;同期 ToyShape 从 3.47% 降到 2.32%,SimObject 从 9.95% 降到 8.90%。论文给出的解释是,合成数据集分布更简单规整,能从更细粒度的求解器中获益,而真实数据分布更复杂,更多步数可能过拟合局部不一致,从而放大幻觉。
更高阶的求解器带来的是一次明确的取舍。DPM-Solver-2 在相同步数下总体失败率更低,却把计数幻觉率推高:在 RealHand 上以标准高斯噪声运行时,25 步计数幻觉率 14.48%、非计数类失败率 9.33%、总体失败率 23.82%;50 步则分别为 15.99%、7.22%、23.21。同一组配置下 DPM-Solver-1 的 50 步结果是计数幻觉率 13.85%、非计数类失败率 12.51%、总体失败率 26.36%。换算下来,DPM-Solver-2 把非计数类失败率从 12.51% 压到 7.22%,但计数幻觉率不降反升。论文的结论是,使用更多算力、更好的采样条件确实持续改善了整体感知质量,却并不保证手指数量这类事实正确。
祖先采样在全部对比中表现最好。DDPM 使用 1000 步,在 ToyShape、SimObject 和 RealHand 上的计数幻觉率分别为 0.64%、4.99% 和 10.75%,非计数类失败率与总体失败率同样最低,总体失败率 13.14%。论文认为,这为生成模型的失败率提供了一个现实的底线,祖先采样因此成为抑制幻觉的有效策略。初始噪声的选法同样有影响:使用“扩散”噪声(即真值初始噪声)相比标准高斯噪声,在大多数配置下同时降低了计数幻觉率、非计数类失败率和总体失败率,论文将其解释为更贴近训练时初始噪声分布的初始化有助于缓解幻觉。
更关键的一组发现指向了常用评价指标的局限。计数幻觉率与 FID 的相关性并不稳定:在 SimObject 上二者呈显著正相关,Pearson 系数 0.87,p 值为 0.01,图像质量越高、计数幻觉越少;但在 RealHand 上却是强负相关,Pearson 系数 -0.97,p 值远小于 0.01。把 DDPM 的结果一并纳入后,这种相关性明显减弱,SimObject 降至 0.49、p 值 0.14,RealHand 为 -0.53、p 值 0.13。相比之下,非计数类失败率与 FID 的相关性始终稳定且显著,RealHand 上 Pearson 系数 0.99、p 值远小于 0.01,另一个手部数据集 PTI-Hand 上为 0.93。论文据此指出,FID 能衡量视觉质量,却无法反映模型在计数这类事实层面是否可靠。
针对这一点,团队提出了联合扩散模型 JDM。该方法在训练时把原始手部图像和对应的分割掩码在通道维度进行拼接,掩码由 SAM-2 提取,去噪 UNet 的输入与输出通道相应扩展到 3+3=6 个通道,使模型在共享潜在空间内同时学习视觉表征与结构约束。效果上,JDM 在全部采样条件下计数幻觉率和非计数类失败率都低于原版扩散模型:计数幻觉率从 12.95%–15.99% 的区间降到 9.66%–11.41%,非计数类失败率从 7.22%–18.06% 降到 2.26%–4.63%。代价是 FID 反而升高,从 23.42–29.86 升到 32.07–37.69。论文将其概括为在感知质量与结构真实性之间作出的取舍——小型训练条件下联合建模两种模态加重了去噪负担。
这类缺陷并非扩散模型独有。视觉语言模型在计数上的表现同样脆弱。一项由奥本大学和阿尔伯塔大学研究者发起的“视力测试”,让 GPT-4o、Gemini-1.5 Pro、Claude-3 Sonnet 和 Claude-3.5 Sonnet 判断两条线段有几个交点、两个圆是否相交、字母被红圈圈住的数量、重叠图形与嵌套正方形的个数、表格的行数列数、以及地铁线路图上的路径条数。结果是数线条交点时表现最佳者 Sonnet-3.5 也只有 77.33% 的准确率;判断两圆位置关系最好的 Gemini-1.5 为 92.78%;重叠正方形嵌套计数中,GPT-4o 准确率 48.33%、Sonnet-3 为 55.00%,而 Gemini-1.5 达 80.00%、Sonnet-3.5 达 87.50%;五边形计数上差距更明显,Sonnet-3.5 为 75.83%,Gemini-1.5 只有 9.16%。四个模型数五个圆环时都达到 100% 准确率,仅仅多添加一个圆环,准确率就大幅降到接近零;计算六到九个形状对所有模型都很困难,Gemini-1.5 在 98.95% 的试验中会把圆的数量预测为“5”。
视觉编码层面的机制也在同期被拆解。清华大学、新加坡国立大学与中国科学院大学的一项研究指出,GPT-4V 对一张不复杂图像里的苹果数量都可能数不对。研究者合成位置可变、数量不变的圆形图像向模型提问,发现回答数量与目标位置高度相关,中央正方形区域响应数量最高,角落区域最接近真值;除正确答案外,还出现 8 个圆和 16 个圆两类异常答案,呈数量翻倍或四倍模式,原因指向图像分辨率无法被 512 整除时切片之间的重叠。开源模型 LLaVA-1.5 则存在大范围填充问题,把图像填充为正方形后有效计算量可能只剩 25%,且模型难以区分填充像素与真实像素。论文提出 LLaVA-UHD 以模块化策略切片、压缩视觉 token 并组织位置编码,在 9 个主流基准上相对 LLaVA-1.5 取得提升。
从消费级产品的表现看,这类缺陷长期存在。Midjourney 生成的图像里出现过三条手臂和七根手指;伦敦大学学院的计算机科学家彼得·本特利给出的解释是,这类工具基于二维模型训练,对真实世界的三维样貌缺乏认知。生成视频模型在同一个环节同样失手:Sora 2 在提示词要求一人从 1 数到 10 并同时举起手指时,喊出的数字与举起的手指数对不上;同一提示词在更早时候用于测试 Veo3,数字只数到 3。图像生成与视频生成模型对数量的控制,仍是目前尚未解决的问题。
常见问题
为什么在真实手部数据上增加扩散模型的采样步数反而加剧了计数幻觉?
在RealHand真实手部数据上,使用DPM-Solver-1时,采样步数从25步增加到100步,计数幻觉率从12.95%上升至14.55%,论文解释为真实数据分布更复杂,更多步数可能导致过拟合局部不一致从而放大幻觉。
联合扩散模型JDM在抑制计数幻觉方面有什么具体效果与代价?
JDM通过拼接图像与SAM-2分割掩码训练,将计数幻觉率从12.95%-15.99%的区间降至9.66%-11.41%,非计数类失败率从7.22%-18.06%降至2.26%-4.63%,但代价是FID指标从23.42-29.86升高至32.07-37.69。
研究团队使用了哪些数据集来量化扩散模型的计数幻觉?
研究团队构建了CountHalluSet数据集套件,包含三个子集:ToyShape有30000张几何图形图,SimObject有30000张虚幻引擎5渲染物体图,RealHand由5050张人手图像构成。
扩散模型的计数幻觉率与FID指标之间存在怎样的相关性?
在SimObject子集上计数幻觉率与FID呈显著正相关,Pearson系数为0.87;但在RealHand子集上呈强负相关,Pearson系数为-0.97,表明FID无法可靠反映模型在计数这类事实层面的准确性。
 冀公网安备13068102000496号