云知声
云知声 U2-TTS 语音 语音合成
U2-TTS 把拟人化细节、风格/情绪控制与多语种多方言能力结合起来,让同一段文字既能用于严肃的业务播报,也能切换成更有感染力的角色口吻,适配不同内容与品牌表达。同时支持长文本异步合成与丰富音频输出配置,便于接入生产流程做规模化生成,在"好听"和"好用"之间取得平衡。
U2-TTS 语音 语音合成
24 项参数 ›
人工智能、大模型与智能体深度观察 | 大观视界
人工智能、大模型与智能体深度观察 | 大观视界
收录人工智能产品与智能体,逐款标注官网、定价模式与支持平台 共 8 款
U2-TTS 把拟人化细节、风格/情绪控制与多语种多方言能力结合起来,让同一段文字既能用于严肃的业务播报,也能切换成更有感染力的角色口吻,适配不同内容与品牌表达。同时支持长文本异步合成与丰富音频输出配置,便于接入生产流程做规模化生成,在"好听"和"好用"之间取得平衡。
TTS-Clone 支持极少语音样本快速复刻目标音色,并生成高度还原、具备情感表达能力的自然语音。复刻音色可长期留存、反复调用,助力打造可沉淀、可复用的专属声音资产。
本次评测覆盖了从底层感知(病灶检测、定位)到高层推理(临床决策、高级医学推理)的完整能力栈,18 个子任务横跨 CXR / CT / MRI 等多模态影像,能够较全面地反映模型在真实医学影像场景中的综合水平。U2-RadiMed 以 55.47% 的综合准确率位列第 1,是唯一突破准确率50%的模型。
U1-OCR 是一款智能文档解析与抽取模型,突破传统 OCR 仅字符识别的局限,实现从“认字”到“懂文档、会提取”的升级。可一站式完成证照识别、版式还原、关键信息抽取,将非结构化文档自动转为规整可用的数据,覆盖日常办公、证照票据、复杂报表等全场景,大幅节省人工录入与核对时间。
U1-OCR-MED 在医疗文书分类、多场景信息抽取任务上表现全面领先,医疗文书分类准确率达 98.2%,综合识别能力显著优于 Gemini、Qwen 等同级别主流大模型;票据类抽取准确率 95.31%、病历类抽取准确率 95.65%,面对专业医学术语、差异化行文表述仍保持高精准度,达到行业领先水准;卡证类抽取准确率高达 98.87%,具备极强的场景适配性与识别稳定性,能够满足医疗业务高精度、高可
支持中文、英文及阿拉伯语、德语、西班牙语、法语、印尼语、日语、韩语、葡萄牙语、俄语、土耳其语、越南语、泰语、意大利语等 15 个国际语种,同时覆盖粤语、四川话、上海话、闽南话等上百种方言及地方口音,完整涵盖汉语七大方言体系。无论是单一方言表达、多语种混合沟通还是跨境业务场景,都能够准确识别并转成文字。
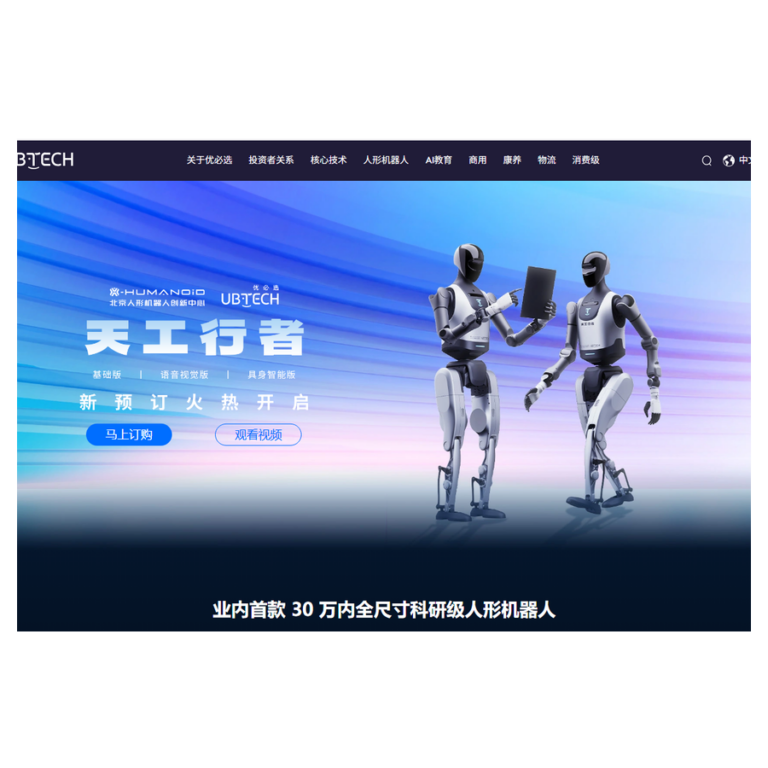
人形机器人科研共研共创基金,由优必选科技牵头,联合创新中心及上下游战略合作伙伴,以加速科研创新与场景创新为目标,面向海内外高校、科研机构,开展标准、课题、赛事等专项实施。
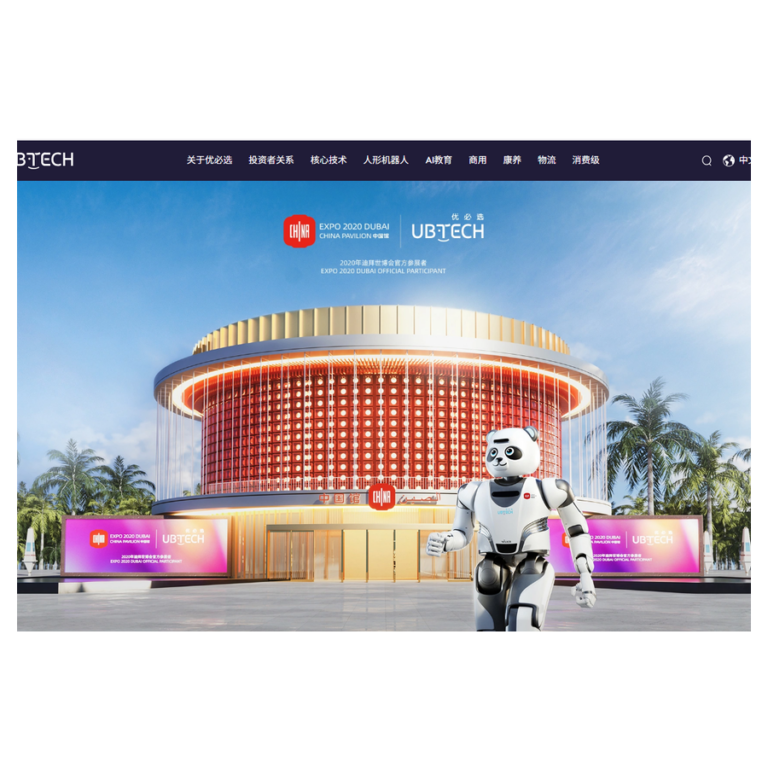
优必选科技以大熊猫的形象为设计原型,在大型人形机器人Walker的基础上,为迪拜世博会中国馆专属定制了熊猫机器人“优悠”。“优悠”将在中国馆的智慧生态分展区,为参观嘉宾介绍中国熊猫生态长卷、智慧农业等展项,展示富有中国传统特色的书写和画画技能,让大家了解中国历来倡导的绿色发展理念,迎接来自全球各地的观众。