壁砺™ 166M 数据中心训推一体 AI 加速风冷 OAM 模组 是什么产品?
壁砺™ 166M 数据中心训推一体 AI 加速风冷 OAM 模组 是壁仞科技的产品,属于AI 训推一体加速卡类别。它的定位是:峰值功耗550W,可适配标准 OAM V1.X 版本的 GPU 服务器,与现有基础设施高度兼容,可广泛应用于大模型、多…。本页收录 11 项官方参数。
企业级IT与信创国产化深度观察 | 大观视界
企业级IT与信创国产化深度观察 | 大观视界
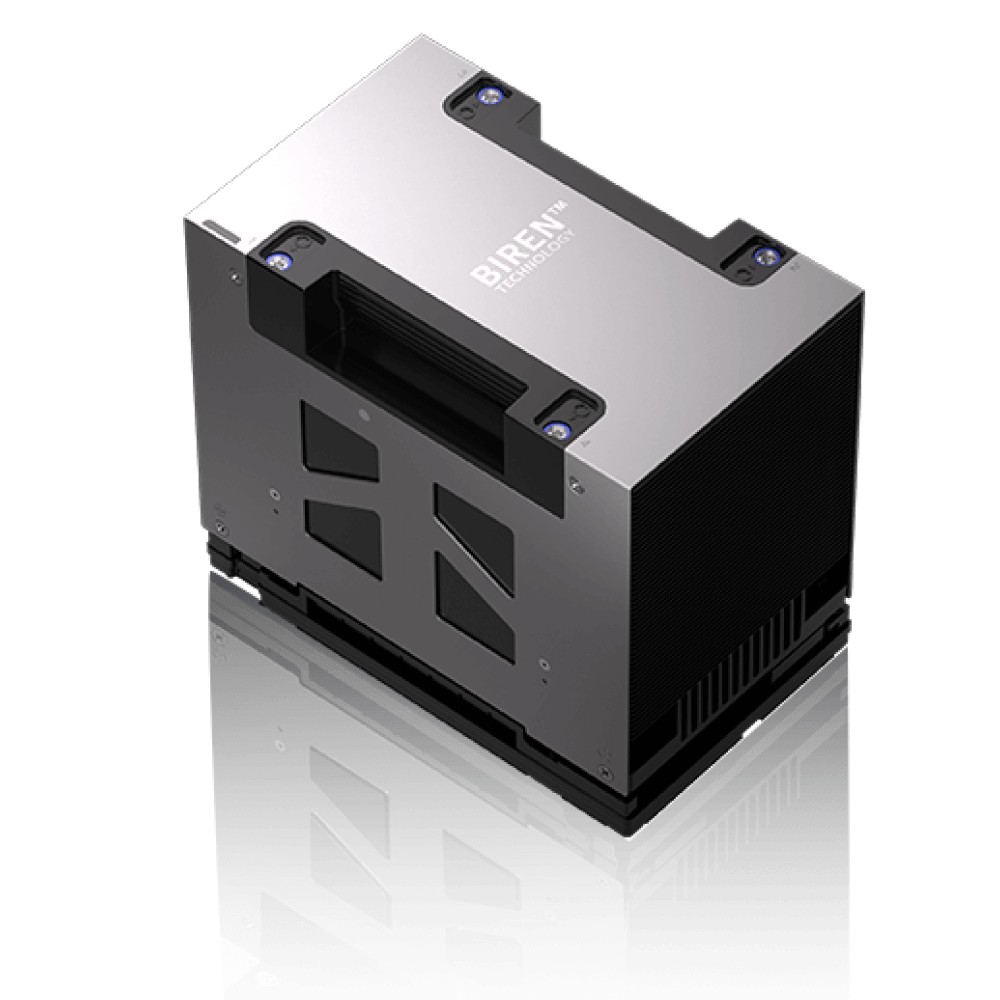
速览
壁砺™ 166M 数据中心训推一体 AI 加速风冷 OAM 模组 是壁仞科技的AI 训推一体加速卡,主要配置为数据中心训推一体 AI 加速风冷 OAM 模组 峰值功耗550W,可适配标准 OAM V1.X 版本的 GPU 服…;产品定位 数据中心训推一体 AI 加速风冷 OAM 模组;产品形态 4…
| 数据中心训推一体 AI 加速风冷 OAM 模组 | 峰值功耗550W,可适配标准 OAM V1.X 版本的 GPU 服务器,与现有基础设施高度兼容,可广泛应用于大模型、多模态 AIGC、图像识别、语音识别、自然语言处理、推荐系统等人工智能训练与推理应用场景 |
|---|---|
| 产品定位 | 数据中心训推一体 AI 加速风冷 OAM 模组 |
| 产品形态 | 4U OAM V1.1 风冷模组 |
| 峰值功耗 | 550W,可适配标准 OAM V1.X 版本的 GPU 服务器 |
| 显存配置 | 64GB 大显存 |
| 显存带宽 | 1.6TB/s 大显存带宽 |
| 硬件加速 | 配备超大 TensorCore 硬件加速 |
| 互联能力 | 支持 PCIe 5.0 x8 主机互联接口技术,通过 UBB 主板实现单机 8 卡互联,每张卡支持 4 端口共 256GB/s 双向互联带宽 |
| 虚拟化 | 最高支持 4 个独立安全虚拟实例(SVI),通过国密一级认证 |
| 模型适配 | 已完成中国移动「九天」35B 大模型全流程适配与推理验证,依托 vLLM 框架与 torch_br 计算库全栈优化 |
| 应用场景 | 大模型、多模态 AIGC、图像识别、语音识别、自然语言处理、推荐系统等训练与推理场景 |
壁砺™ 166M 数据中心训推一体 AI 加速风冷 OAM 模组 是壁仞科技的产品,属于AI 训推一体加速卡类别。它的定位是:峰值功耗550W,可适配标准 OAM V1.X 版本的 GPU 服务器,与现有基础设施高度兼容,可广泛应用于大模型、多…。本页收录 11 项官方参数。
550W,可适配标准 OAM V1.X 版本的 GPU 服务器。(来源:厂商官方参数)同时,数据中心训推一体 AI 加速风冷 OAM 模组:峰值功耗550W,可适配标准 OAM V1.X 版本的 GPU 服务器,与现有基础设施高度兼容,可广泛应用于大模型、多模态 AIGC、图像…。
本站AI 训推一体加速卡分类下还有 沐曦 曦索X302、沐曦 曦索X301、沐曦 曦索X206、沐曦 曦云C600 等型号,都可以在产品库里按参数逐项对比。共收录该类产品 36 款。
本站不提供报价。166M 的价格随机型配置、采购渠道和项目规模浮动,建议到壁仞科技官网或授权经销商询价。本站只整理公开的官方参数,供选型比对使用。
参数逐项摘自www.birentech.com 的官方产品页,本站只做字段整理与分类归并,不改写数值。页面底部标注了来源链接与更新时间(2026-11-05)。
壁砺™ 166M 数据中心训推一体 AI 加速风冷 OAM 模组 由壁仞科技推出,官方型号写作 166M。厂商官网:https://www.birentech.com/。
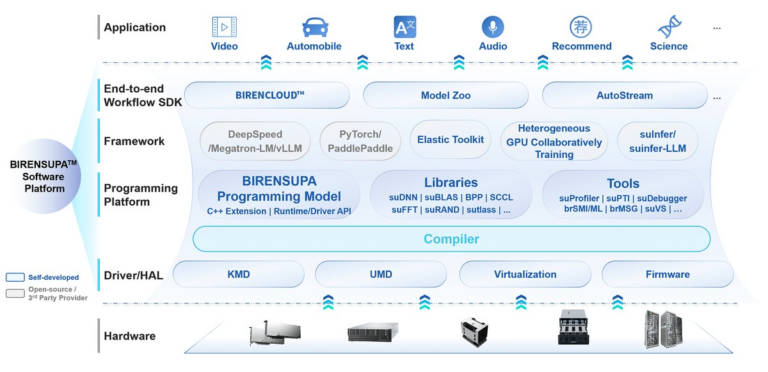
全栈自研 + 软硬件深度协同 充分发挥壁仞自研架构芯片极致性能
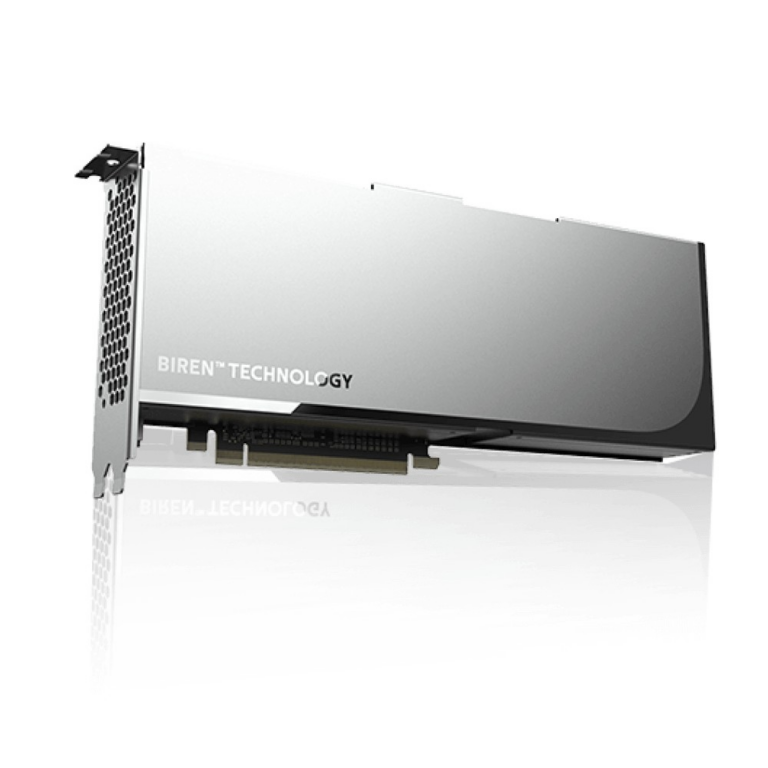
峰值功耗 300W, 可广泛应用于大模型、多模态 AIGC、图像识别、语音识别、自然语言处理、推荐系统等人工智能训练、微调与推理应用场景
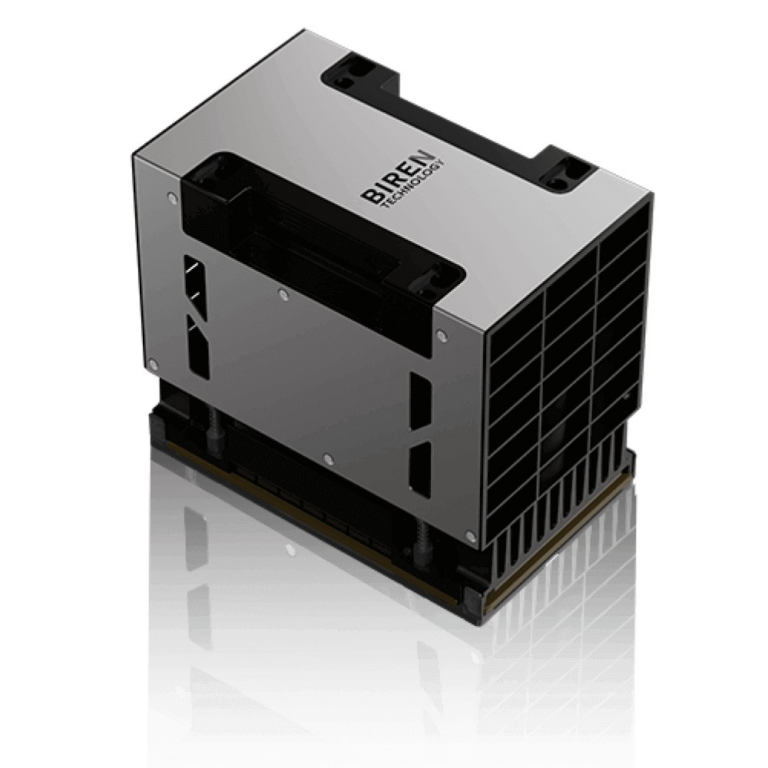
峰值功耗 400W,拥有强大的算力和高速互连能力,可为广泛的人工智能训练场景,提供高能效比的算力解决方案
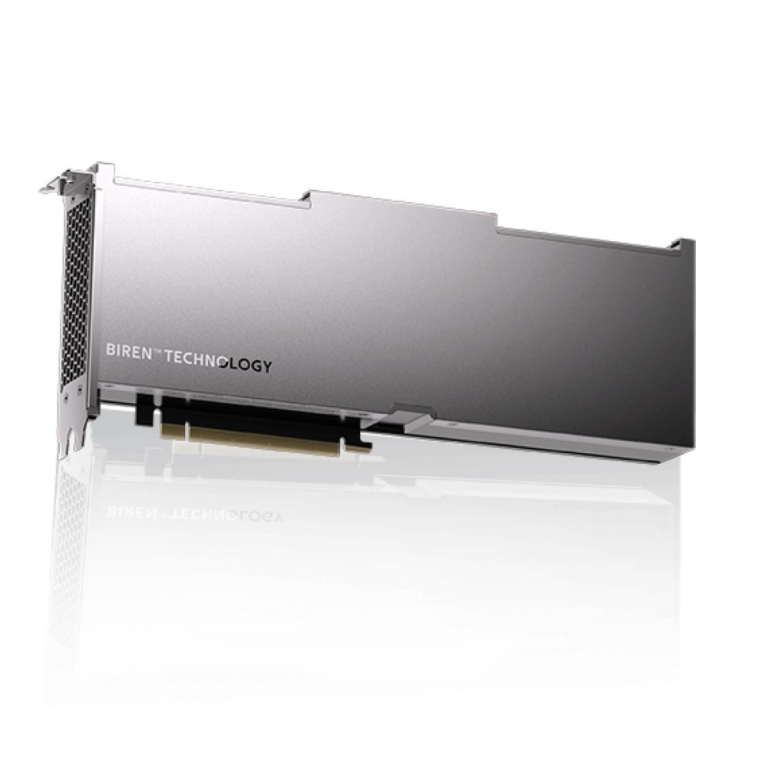
峰值功耗 300W,可灵活适配多种 4-8U 的 PCIe 类型 GPU 服务器,与现有基础设施高度兼容,可广泛应用于大模型、多模态 AIGC、图像识别、语音识别、自然语言处理、推荐系统等人工智能推理应用场景