沐曦
沐曦 曦云C550服务器
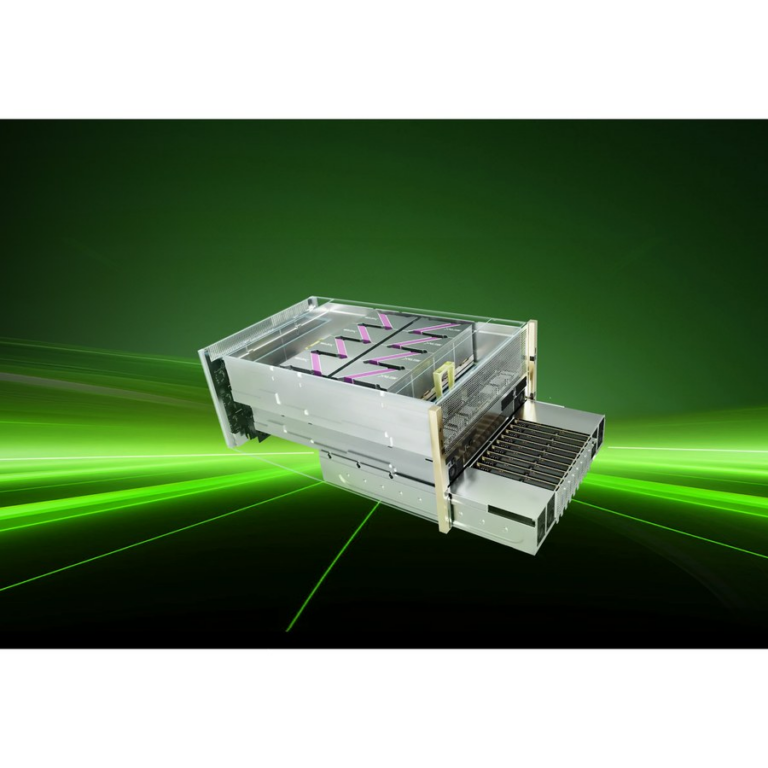
曦云C550 OAM服务器是沐曦股份联合合作伙伴打造的双路标准服务器旗舰产品,单机搭载8块曦云C550标准OAM模组,支持强大的多精度混合算力和8卡全互连拓扑,完美支持智算、通用计算和数据处理等应用场景。
曦云C550服务器
15 项参数 ›
企业级IT与信创国产化深度观察 | 大观视界
企业级IT与信创国产化深度观察 | 大观视界
收录该频道产品,支持按分类与品牌筛选 共 8463 款
曦云C550 OAM服务器是沐曦股份联合合作伙伴打造的双路标准服务器旗舰产品,单机搭载8块曦云C550标准OAM模组,支持强大的多精度混合算力和8卡全互连拓扑,完美支持智算、通用计算和数据处理等应用场景。
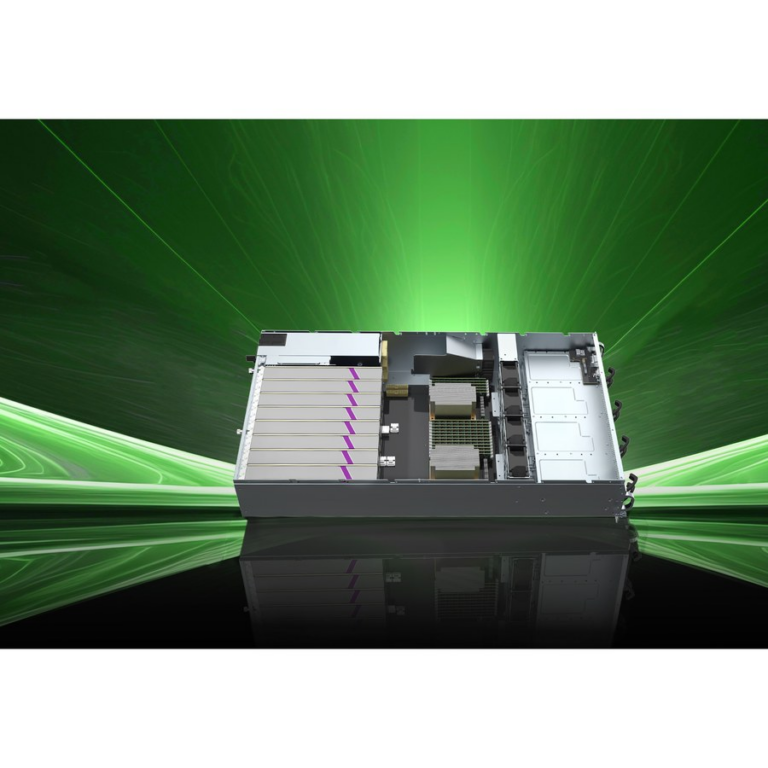
曦思N260服务器是沐曦股份联合合作伙伴打造的标准机架式服务器产品,单机最高搭载8张曦思N260通用GPU,支持强大的多精度混合算力,完美支持高密度推理等应用场景。
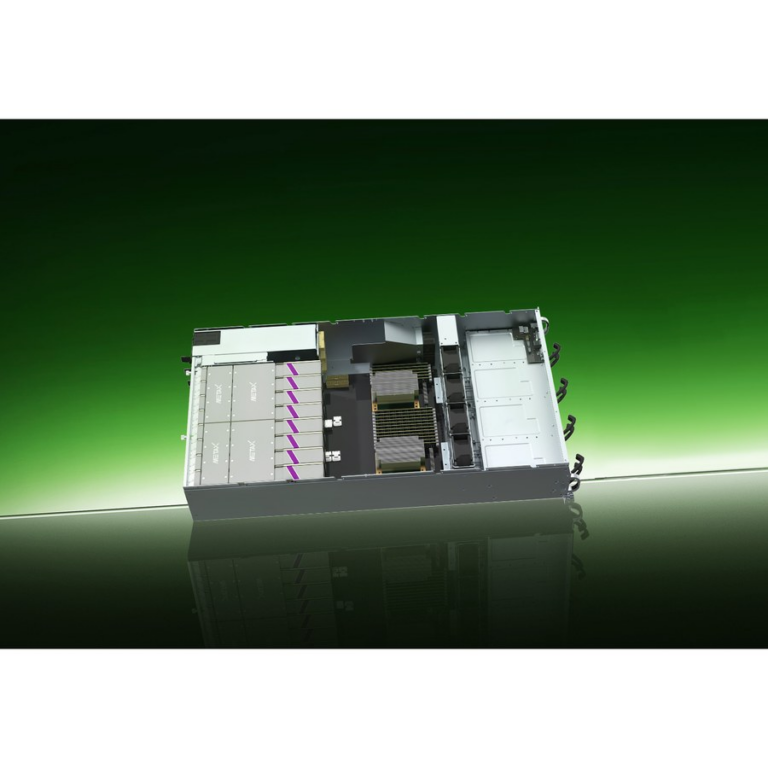
曦云C500服务器是沐曦股份联合合作伙伴打造的标准机架式服务器产品,单机最高搭载16张曦云C500通用计算GPU,支持强大的多精度混合算力和高速卡间MetaXLink互连,完美支持智算、通用计算和数据处理等应用场景。
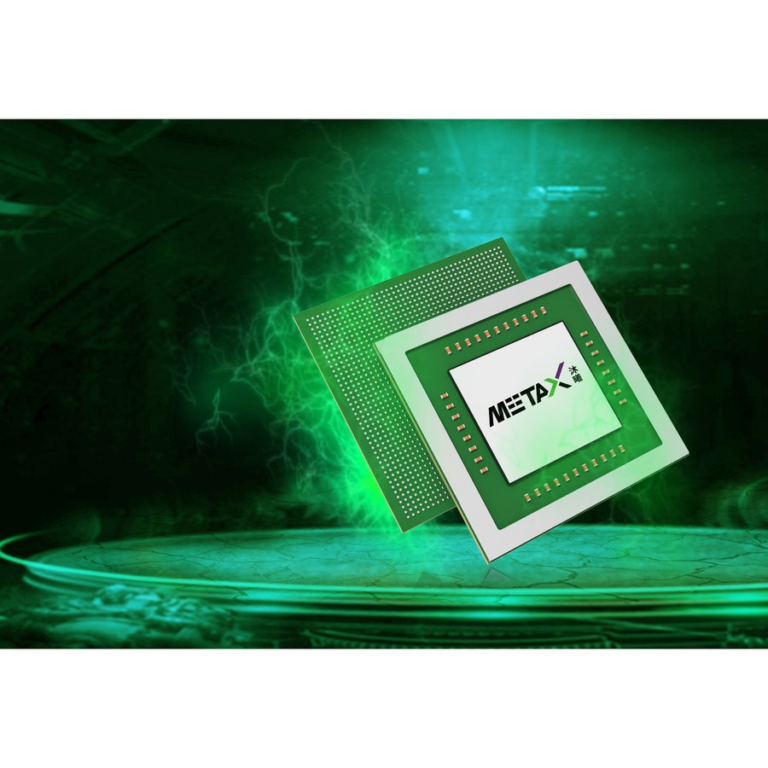
曦彩G100 GPU是针对图形渲染加速的解决方案,沐曦股份自主知识产权架构提供卓越的图形图像渲染与视频处理能力,可广泛应用于元宇宙、云桌面、云游戏、云手机、数字孪生、XR等场景。
曦云C600是沐曦股份基于自主知识产权的GPGPU架构及国产先进工艺研发的新一代通用GPU产品。
曦云C588通用GPU是沐曦股份基于自主知识产权核心GPU IP打造的全新旗舰产品,具有强大的多精度混合算力、超大容量高带宽内存、先进的多卡互连技术、全兼容主流GPU生态的MXMACA软件栈,性能卓越,可高效支持大模型训。
曦云C500X是沐曦股份基于自主知识产权核心GPU IP打造的旗舰级光互连通用GPU创新产品,具有强大的多精度混合算力、大容量高带宽显存、领先的多卡光互连技术,全兼容主流GPU生态的MXMACA软件栈,完美支持智算、通用。
曦云C550是沐曦股份基于自主知识产权核心GPU IP打造的旗舰级OAM模组形态通用GPU产品,支持OAM1.5和2.0标准规范,具有强大的多精度混合算力、大容量高带宽显存、 896GB/s的八卡全互连带宽、全兼容主流G。
曦云C500是沐曦股份基于自主知识产权核心GPU IP打造的旗舰级PCIe板卡形态通用GPU产品,具有强大的多精度混合算力、大容量高带宽显存、先进的多卡互连技术、全兼容主流GPU生态的MXMACA软件栈,完美支持智算、通。
曦思N300是沐曦股份基于自主知识产权GPGPU架构及国产先进工艺打造的新一代通用GPU芯片。
曦思N260是一款适用于多种智慧应用场景的通用GPU(GPGPU),它采用沐曦股份自主知识产权的创新计算架构,可提供强大的多精度混合算力,配以大容量显存和新一代高速IO接口,使GPU算力高效释放。
曦思N100是一款面向多种智慧应用场景的智算推理GPU,它内置创新架构的GPGPU处理器,提供强大的智算推理算力和卓越的视频编解码能力,可广泛应用于智慧城市、智慧交通、智慧教育、智能视频处理等场景。
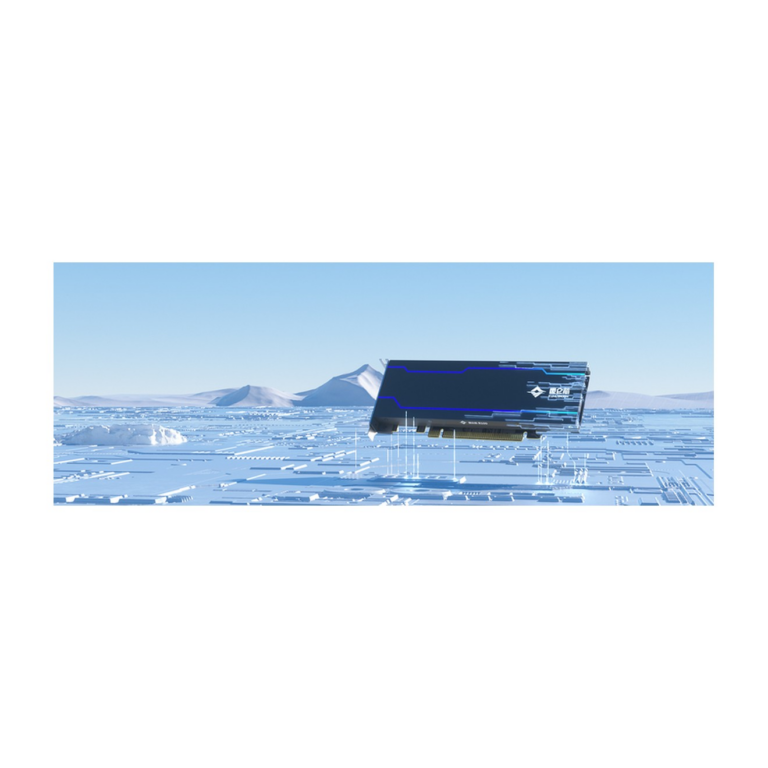
昆仑芯 2 代 XPU-R 架构 AI 加速卡,INT8 算力 128-170 TOPS、FP16 64-85 TFLOPS,12GB GDDR6、384GB/s 访存带宽,PCIe 4.0 x16,支持 84 路 10
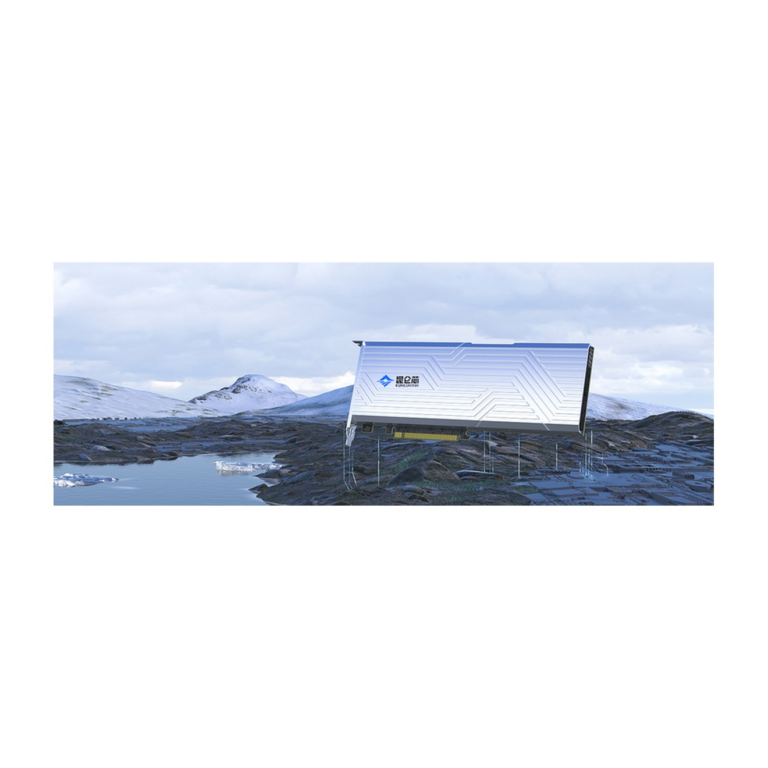
昆仑芯 2 代架构 OAM 形态 AI 加速卡,面向大模型训练与推理集群。
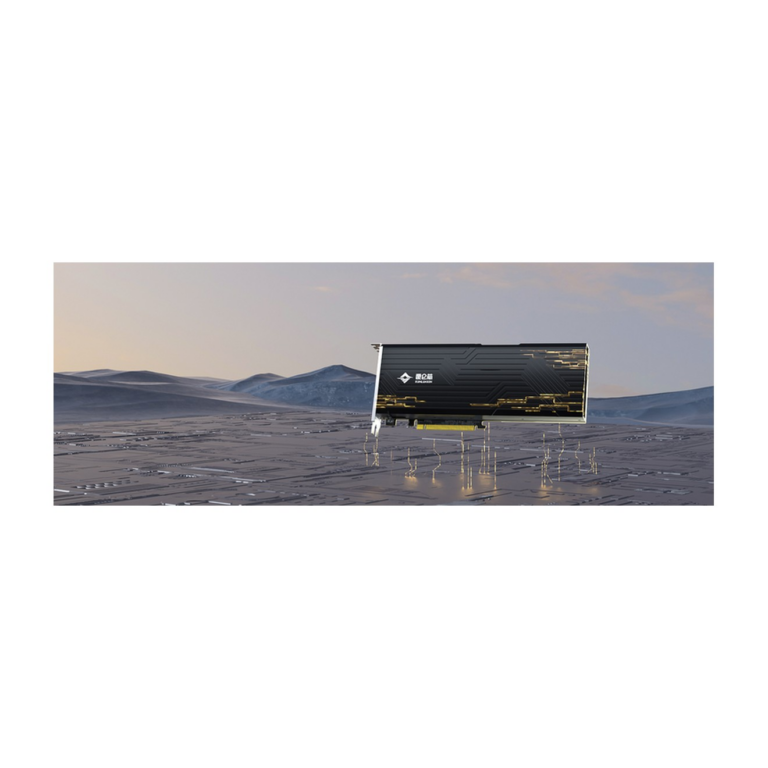
昆仑芯自研新一代 XPU-R 架构 AI 芯片,通用计算核心算力相比 1 代提升 2-3 倍,通用和专用指令集融合,支持训练、推理与虚拟化。
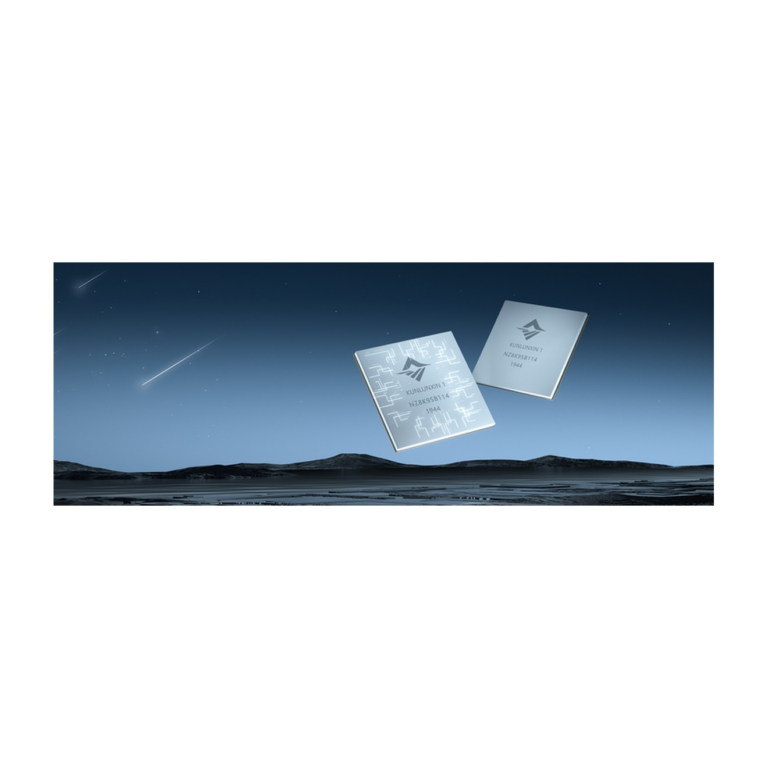
昆仑芯 1 代 XPU 架构 AI 加速卡,面向云端推理场景。
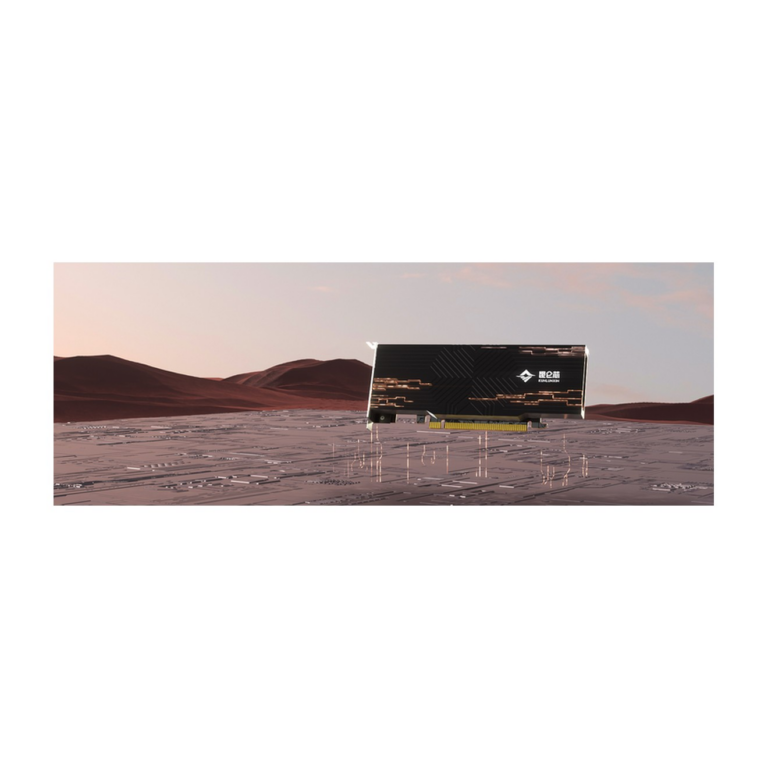
昆仑芯 1 代 XPU 架构 AI 加速卡,支持 INT8/INT16 与 FP16/FP32 精度,实际部署已达数万片。
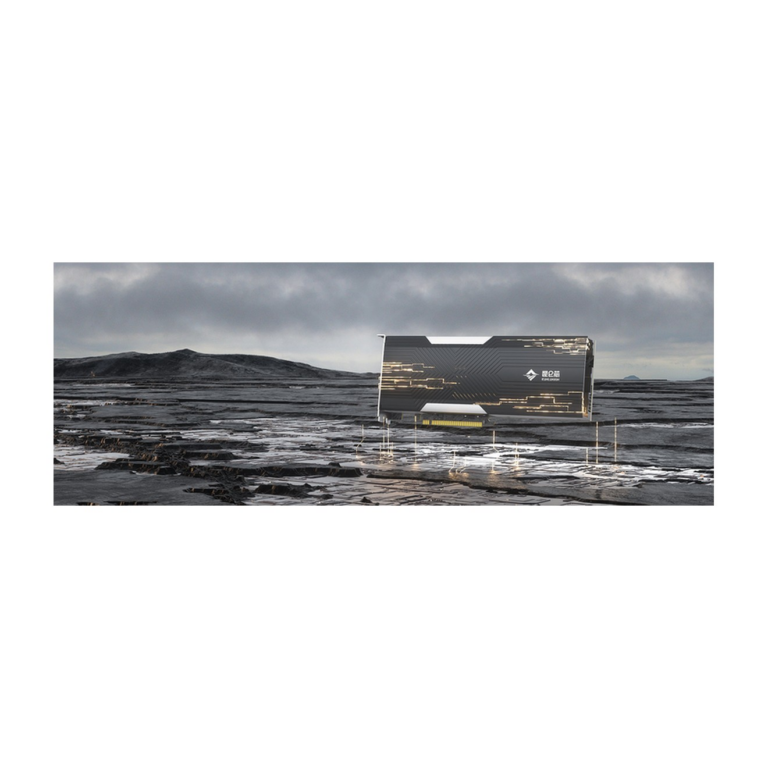
昆仑芯第一代自研 AI 芯片,采用创新 XPU 架构,在互联网、智慧工业、智慧金融等领域均有规模部署。
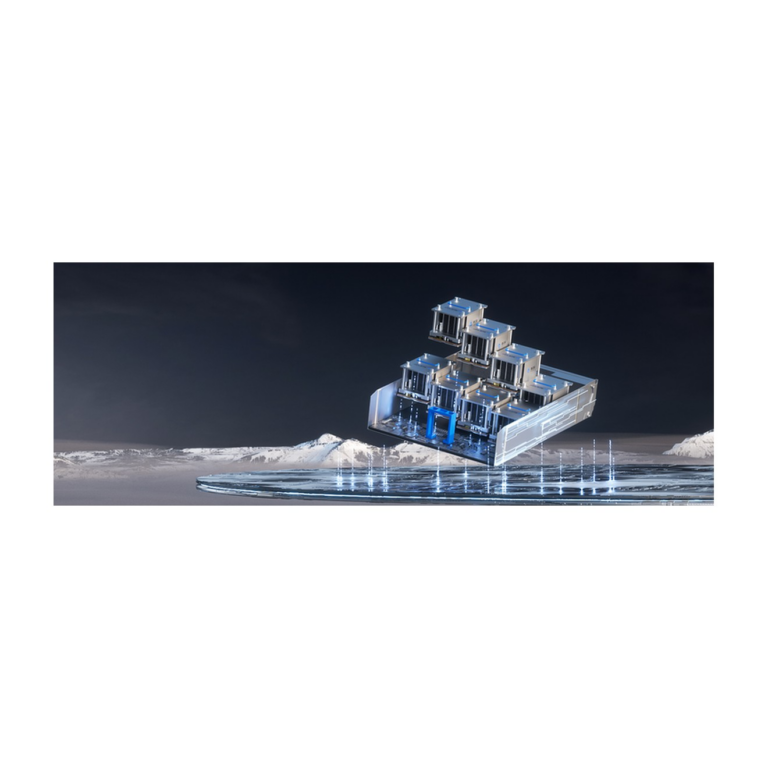
昆仑芯 2 代架构 8 卡一体 AI 加速器组,面向超大规模训练集群提供高带宽互连。
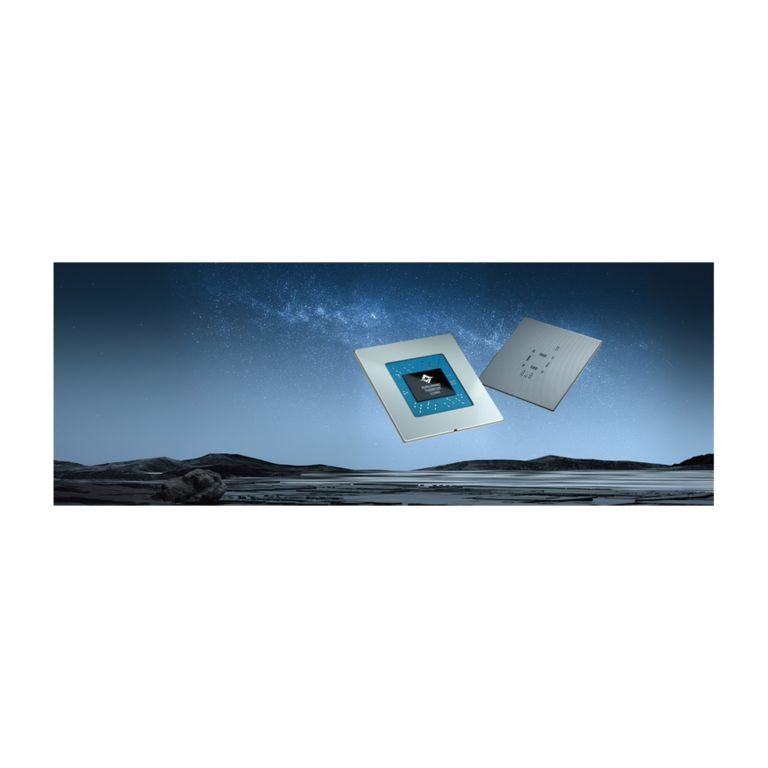
昆仑芯 2 代 XPU-R 架构 AI 加速卡,INT8 算力 256 TOPS,16GB/32GB GDDR6 显存,150W/160W 功耗。
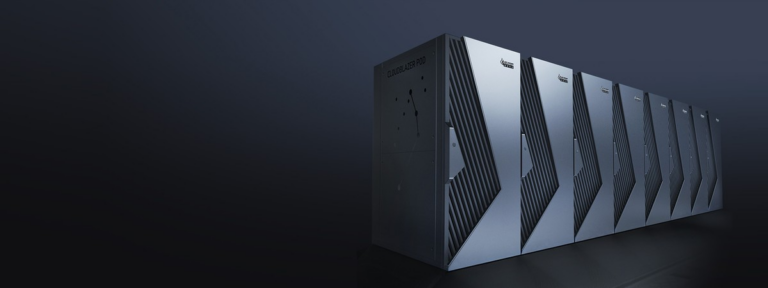
面向大型智算中心的人工智能加速集群,标准化、开箱即用的 AI 算力中心产品,解决数据中心建设标准规范弱、专业性不强、交付周期长等痛点,广泛应用于智慧城市算力底座、科研院所开发用算力集群及企事业单位标准化 AI 算力需求。
燧原云燧 OGX 与云燧超节点智算系统,采用风冷被动散热设计,针对数据中心大规模部署场景优化功耗与散热,支持 7×24 小时集群运行环境。
燧原自主 TopsRider 是软硬件协同架构设计的全栈 AI 软件平台,通过 TopsCodeCC++ API、标准 FFmpeg 插件与 torch_gcu 一键迁移工具链,完整释放邃思芯片性能;包含可视化 AI 开
燧原 GCU 加速卡之间的互连桥接卡,用于构建多卡高速互连拓扑,支持热插拔与高速数据传输。