燧原
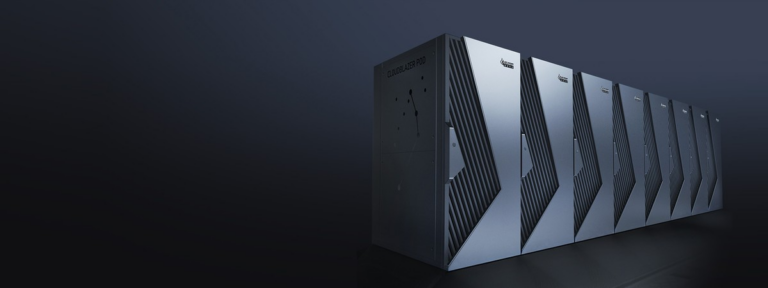
云燧智算集群
面向大型智算中心的人工智能加速集群,标准化、开箱即用的 AI 算力中心产品,解决数据中心建设标准规范弱、专业性不强、交付周期长等痛点,广泛应用于智慧城市算力底座、科研院所开发用算力集群及企事业单位标准化 AI 算力需求。
5 项参数 ›
企业级IT与信创国产化深度观察 | 大观视界
企业级IT与信创国产化深度观察 | 大观视界
收录该频道产品,支持按分类与品牌筛选 共 11 款
面向大型智算中心的人工智能加速集群,标准化、开箱即用的 AI 算力中心产品,解决数据中心建设标准规范弱、专业性不强、交付周期长等痛点,广泛应用于智慧城市算力底座、科研院所开发用算力集群及企事业单位标准化 AI 算力需求。
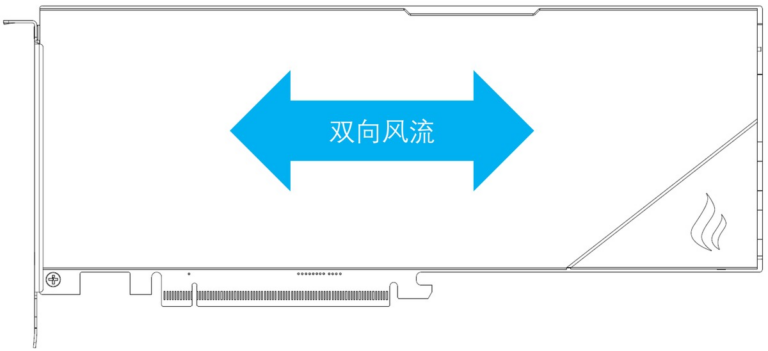
燧原云燧 OGX 与云燧超节点智算系统,采用风冷被动散热设计,针对数据中心大规模部署场景优化功耗与散热,支持 7×24 小时集群运行环境。
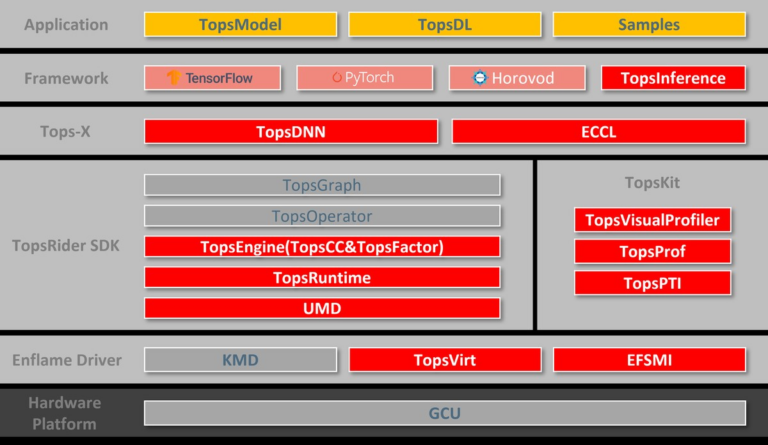
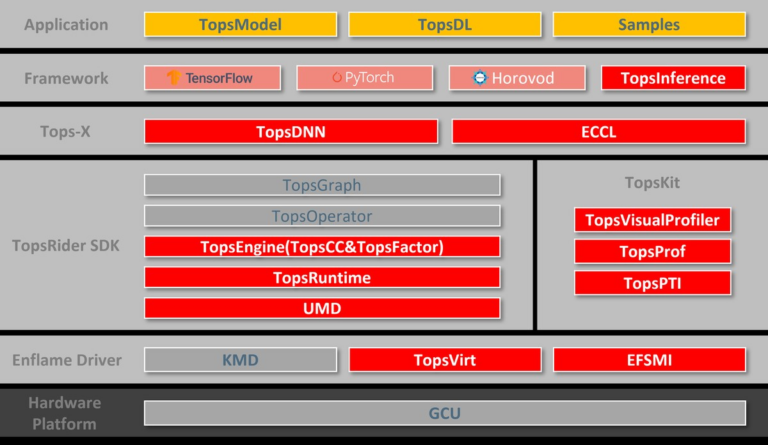
燧原自主 TopsRider 是软硬件协同架构设计的全栈 AI 软件平台,通过 TopsCodeCC++ API、标准 FFmpeg 插件与 torch_gcu 一键迁移工具链,完整释放邃思芯片性能;包含可视化 AI 开
燧原 GCU 加速卡之间的互连桥接卡,用于构建多卡高速互连拓扑,支持热插拔与高速数据传输。
燧原第一代邃思架构训练加速卡,云燧 DTU 系列早期主力产品。
燧原邃思架构训练加速卡,配套 GCU-LARE 互连方案构建高速集群。
燧原第二代邃思架构 OAM 模组形态训练加速卡,适配标准 OAM 模组形态服务器,支持大规模集群训练。
燧原第一代邃思架构训练加速卡,DTU 2.0 芯片,64GB HBM2E(1.8TB/s)、TF32 算力 160 TFLOPS,3306mm² 多芯片 2.5D 封装,面向云端大模型训练。
燧原第一代邃思架构推理加速卡,支持多精度计算与视频编解码加速,面向大规模推理与视频分析场景。
燧原第二代邃思架构推理加速卡,PCIe 标准形态,面向云端推理场景,配套驭算 TopsRider 全栈软件平台。
燧原自主 GCU 架构,面向数据中心大规模部署的新一代人工智能推理加速卡,支持 FP32/FP16/BF16/INT8 全精度,板载 48GB GDDR6(672GB/s、14Gbps),PCIe Gen5 x16 接口