寒武纪
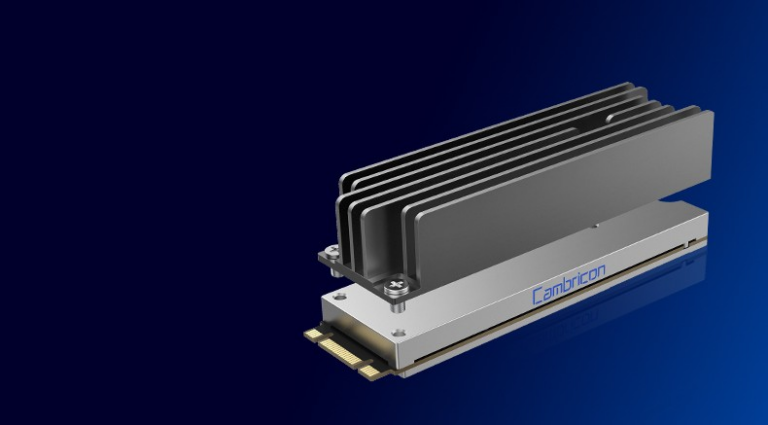
MLU220-M.2 边缘端智能加速卡
MLU220-M.2边缘端智能加速卡
MLU220-M.2边缘端智能加速卡
15 项参数 ›
企业级IT与信创国产化深度观察 | 大观视界
企业级IT与信创国产化深度观察 | 大观视界
收录该频道产品,支持按分类与品牌筛选 共 8463 款
MLU220-M.2边缘端智能加速卡
MLU220-SOM
MLU270-F4智能加速卡
MLU370-X8智能加速卡
MLU270-S4智能加速卡
MLU370-X4智能加速卡
MLU370-S4/S8智能加速卡
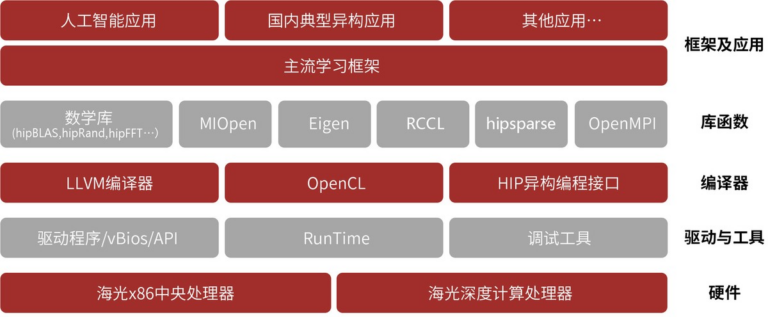
基于主流通用并行计算架构,可搭配海光 CPU 使用,支撑 AI 训练推理与科学计算
面向多场景的高性价比处理器,4-8 核 / 最高加速频率 3.3 GHz
面向行业客户的主流中端处理器,8-16 核 / 64 路 PCIe / 1TB 内存
面向数据中心的旗舰级高性能处理器,16-32 核 / 128 路 PCIe / 2TB 内存
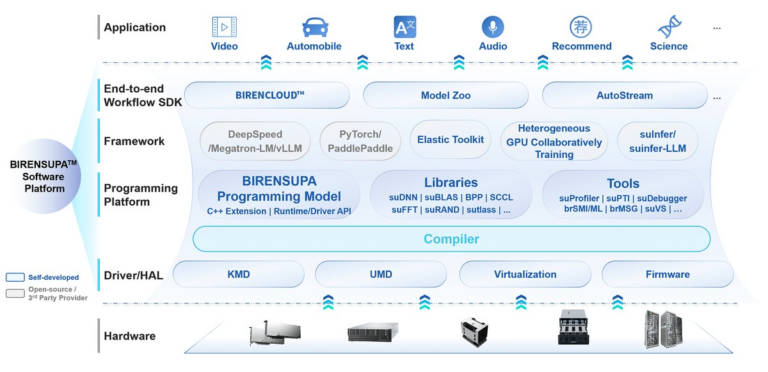
全栈自研 + 软硬件深度协同 充分发挥壁仞自研架构芯片极致性能
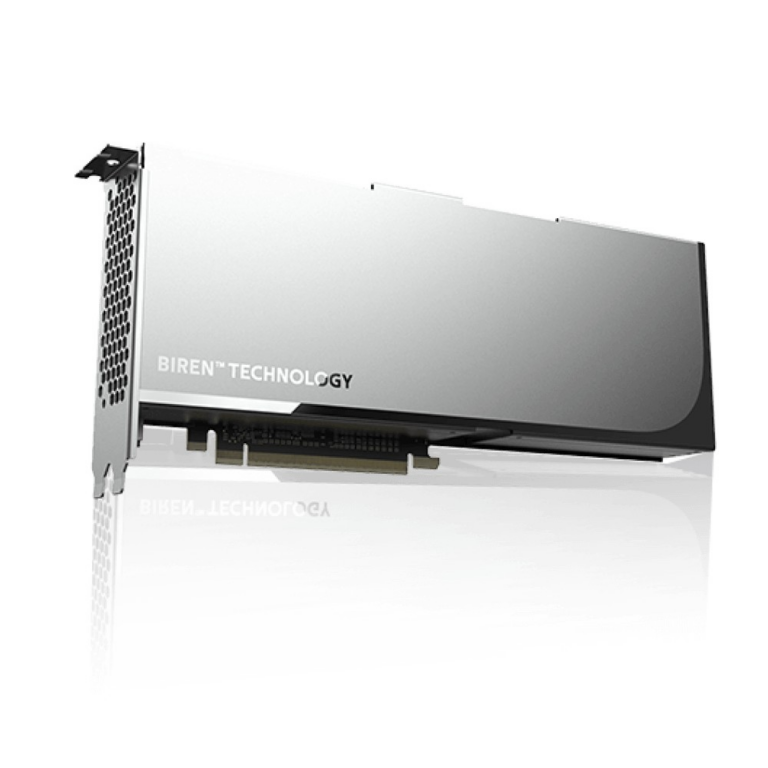
峰值功耗 300W, 可广泛应用于大模型、多模态 AIGC、图像识别、语音识别、自然语言处理、推荐系统等人工智能训练、微调与推理应用场景
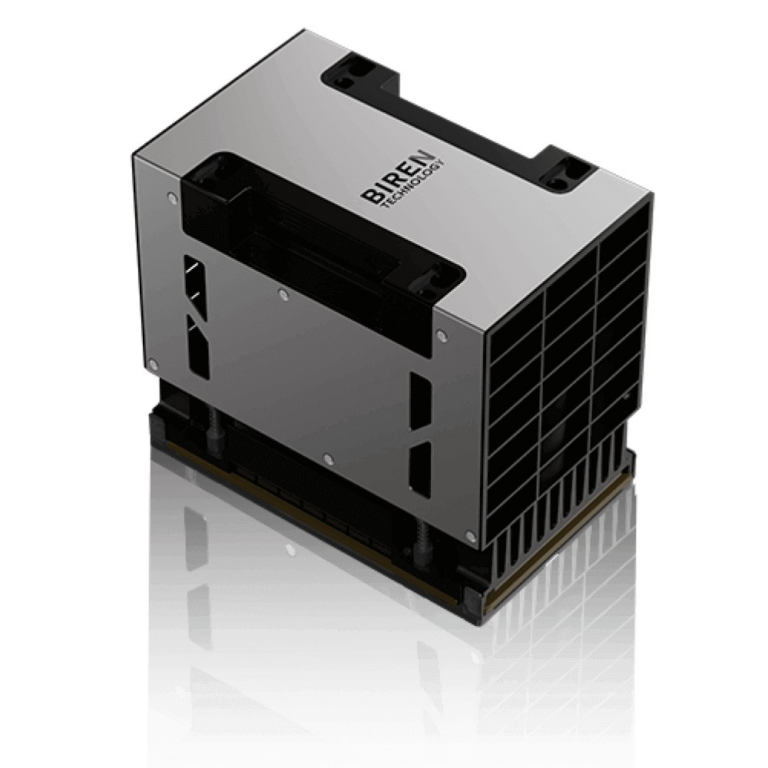
峰值功耗 400W,拥有强大的算力和高速互连能力,可为广泛的人工智能训练场景,提供高能效比的算力解决方案
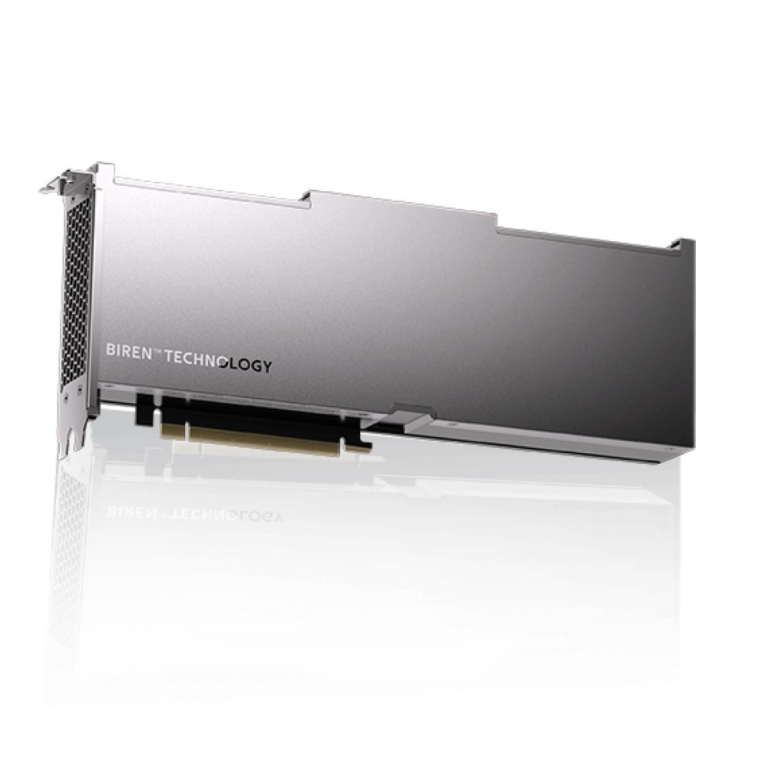
峰值功耗 300W,可灵活适配多种 4-8U 的 PCIe 类型 GPU 服务器,与现有基础设施高度兼容,可广泛应用于大模型、多模态 AIGC、图像识别、语音识别、自然语言处理、推荐系统等人工智能推理应用场景
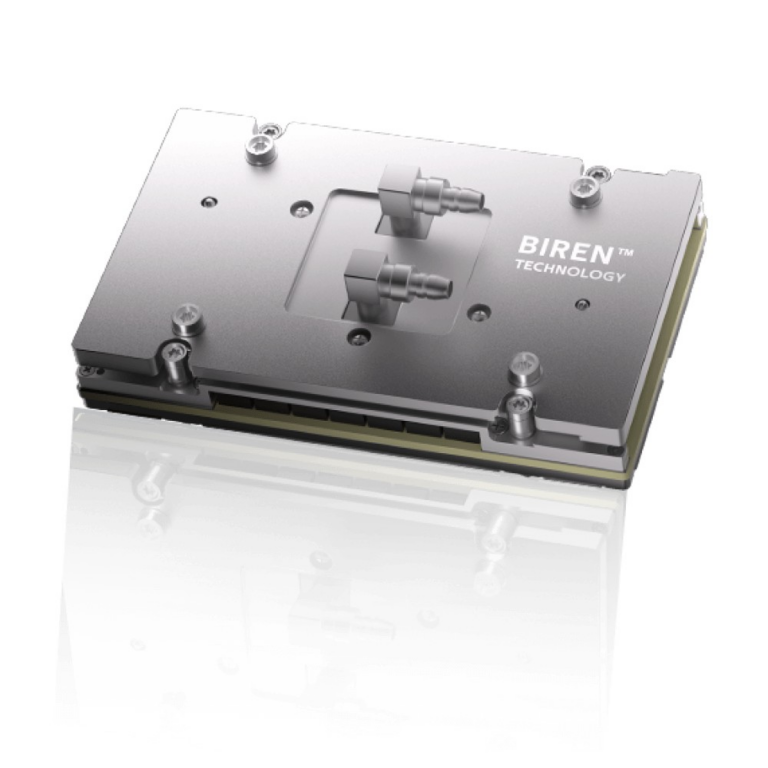
峰值功耗 600W,可灵活适配标准 OAM V1.X版本的 GPU 服务器,与现有基础设施高度兼容,可广泛应用于大模型、多模态 AIGC、图像识别、语音识别、自然语言处理、推荐系统等人工智能训练与推理应用场景。
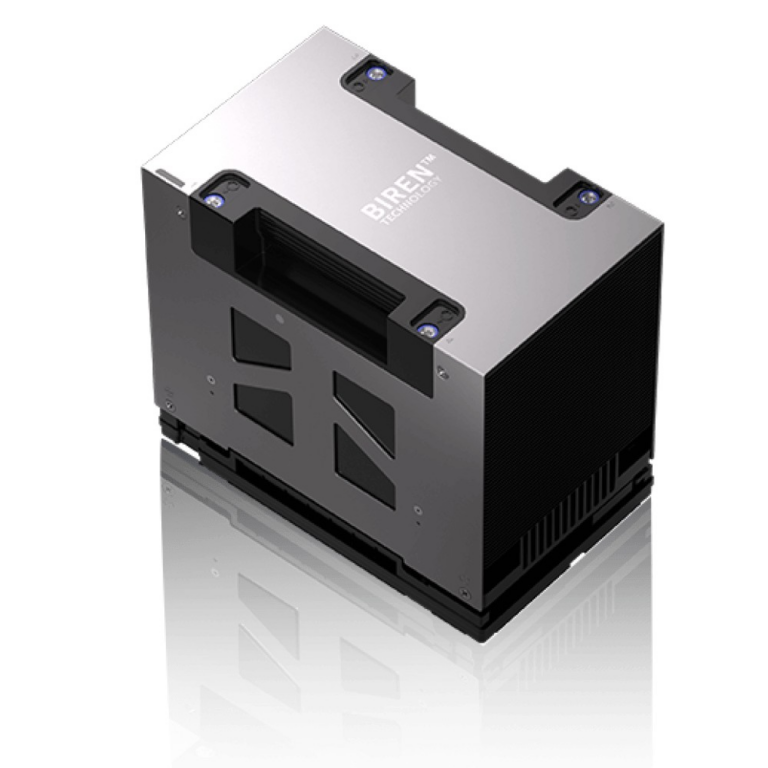
峰值功耗550W,可适配标准 OAM V1.X 版本的 GPU 服务器,与现有基础设施高度兼容,可广泛应用于大模型、多模态 AIGC、图像识别、语音识别、自然语言处理、推荐系统等人工智能训练与推理应用场景
AI Reality 是摩尔线程 AI Reality 产品体系中的产品。
覆盖线性代数、傅里叶、稀疏矩阵与并行原语
运动加加 小美 APP
KUAE 云原生套件 是摩尔线程 KUAE 云原生套件 产品体系中的产品。
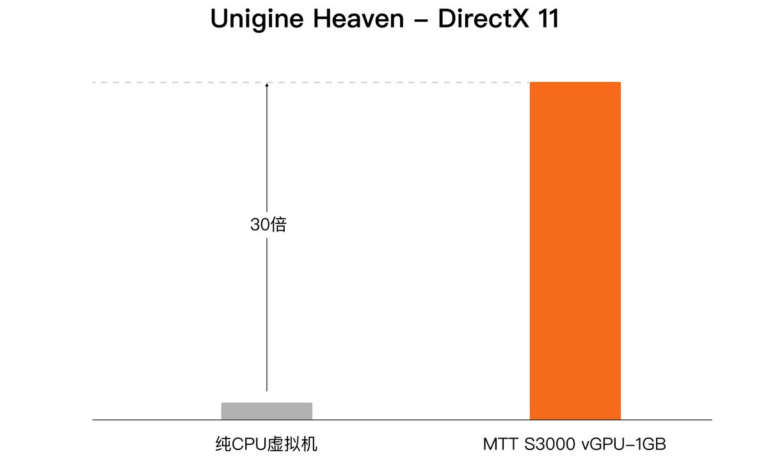
GPU 虚拟化 是摩尔线程 GPU 虚拟化 产品体系中的产品。
摩尔线程 AI 推理套件
为 MUSA 开发者打造的 AI 编程能力矩阵